全国大学生一站式资讯、文学、实践服务平台

北京清华长庚医院药学部合作发布AI驱动核酸适配体开发综述
- 发布时间:2026-11-18 阅读:
- 来源:多彩大学生网
核酸适配体是一类可通过独特的三维折叠结构,特异性识别蛋白质、小分子、病毒颗粒乃至金属离子等多种靶标的短链寡核苷酸,在疾病诊断、靶向治疗与生物传感领域潜力巨大。然而,由于文库容量有限,候选序列数量受限,聚合酶链式反应(polymerase chain reaction,PCR)扩增易产生偏倚,且需多轮反复筛选,操作繁琐、耗时较长,传统指数富集的配体系统进化技术(Systematic Evolution of Ligands by Exponential Enrichment,SELEX)筛选核酸适配体如同“大海捞针”。
近年来,AI的引入正推动该领域从传统的经验性筛选向理性的、数据驱动的设计模式转变。10月20日,清华大学北京清华长庚医院药学部副主任药师王兰联合中国医学科学院医药生物技术研究所副研究员杨歌,系统梳理了人工智能(AI)在核酸适配体开发全流程中的前沿进展,为下一代适配体的发现与工程化改造提供了参考路线图。
图1直观展示了传统SELEX工作流程与AI辅助虚拟文库工作流程的对比。传统流程需要合成庞大的随机文库,并经历多轮“结合—洗涤—扩增”的漫长过程,极易产生PCR偏倚;而AI辅助流程通过变分自编码器(VAE)、生成对抗网络(GAN)或扩散模型,在计算机内构建规模远超物理合成容量的虚拟序列库,经计算预测与筛选后,仅需合成几百条高潜力候选序列直接进行实验验证。这一转变不仅规避了PCR偏倚,还能按需富集复杂结构,极大提高了研发效率。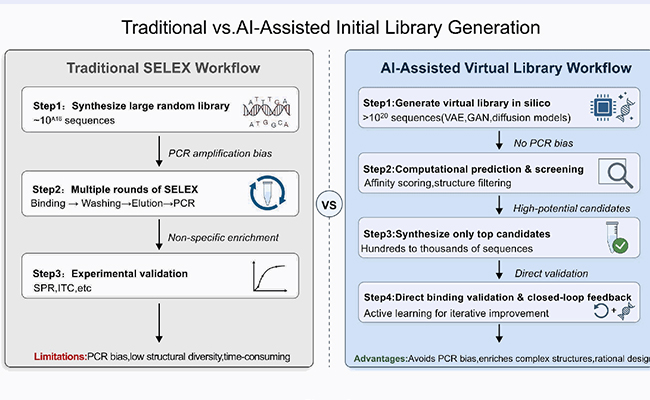
图1.传统初始文库生成与AI辅助初始文库生成对比
在此基础上,该综述系统介绍了AI驱动的适配体研发全流程,涵盖从生物信息学数据库建设、高通量SELEX数据分析,到二级与三级结构预测、分子对接、分子动力学模拟及自由能计算的完整技术链条,并重点评述了AlphaFold 3、RoseTTAFoldNA等深度学习模型在核酸结构预测中的最新突破。区别于仅关注单一计算工具或传统SELEX方法优化的综述,本文进一步将AI视为驱动适配体设计的“新引擎”,重点分析了近年来生成式AI在从头设计中的颠覆性作用,包括基于扩散模型的AptaDiff、基于大语言模型的InstructNA与GRAPE-LM和基于深度强化学习的AiDTA等(图2)。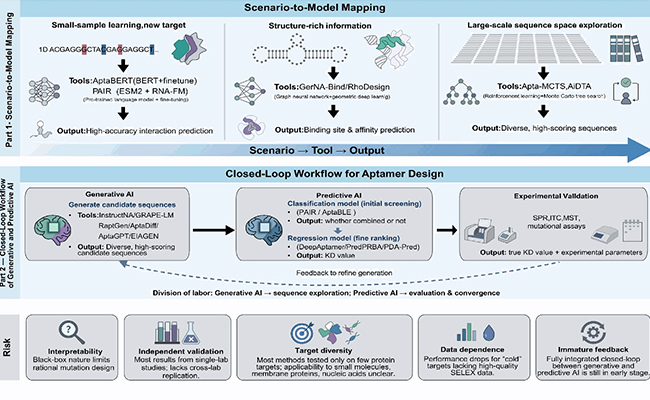
图2. AI驱动适配体设计的闭环流程与场景化工具选择
文章最后指出,尽管AI显著加速了候选序列的虚拟预筛选,但当前仍面临数据标准化缺失、模型可解释性不足、对化学修饰核苷酸编码能力有限等挑战。未来应进一步结合主动学习、多模态数据融合和前瞻性实验验证,构建闭环、可解释的AI框架,协调计算预测与实验验证之间的反馈,从而提高适配体设计的成功率与临床转化效率。
该研究以“超越SELEX:AI驱动的适配体——从序列到结构再到功能”(Beyond SELEX: AI-driven aptamers from sequence to structure to function)为题,于10月20日在线发表于《生物技术进步》(Biotechnology Advances)。
北京清华长庚医院药学部崔博铭博士为论文第一作者,王兰、杨歌为论文共同通讯作者。
研究工作得到了中国医学科学院医学与健康科技创新工程(CIFMS)和北京研究型病房卓越计划(BRWEP)的资助。
近年来,AI的引入正推动该领域从传统的经验性筛选向理性的、数据驱动的设计模式转变。10月20日,清华大学北京清华长庚医院药学部副主任药师王兰联合中国医学科学院医药生物技术研究所副研究员杨歌,系统梳理了人工智能(AI)在核酸适配体开发全流程中的前沿进展,为下一代适配体的发现与工程化改造提供了参考路线图。
图1直观展示了传统SELEX工作流程与AI辅助虚拟文库工作流程的对比。传统流程需要合成庞大的随机文库,并经历多轮“结合—洗涤—扩增”的漫长过程,极易产生PCR偏倚;而AI辅助流程通过变分自编码器(VAE)、生成对抗网络(GAN)或扩散模型,在计算机内构建规模远超物理合成容量的虚拟序列库,经计算预测与筛选后,仅需合成几百条高潜力候选序列直接进行实验验证。这一转变不仅规避了PCR偏倚,还能按需富集复杂结构,极大提高了研发效率。
图1.传统初始文库生成与AI辅助初始文库生成对比
在此基础上,该综述系统介绍了AI驱动的适配体研发全流程,涵盖从生物信息学数据库建设、高通量SELEX数据分析,到二级与三级结构预测、分子对接、分子动力学模拟及自由能计算的完整技术链条,并重点评述了AlphaFold 3、RoseTTAFoldNA等深度学习模型在核酸结构预测中的最新突破。区别于仅关注单一计算工具或传统SELEX方法优化的综述,本文进一步将AI视为驱动适配体设计的“新引擎”,重点分析了近年来生成式AI在从头设计中的颠覆性作用,包括基于扩散模型的AptaDiff、基于大语言模型的InstructNA与GRAPE-LM和基于深度强化学习的AiDTA等(图2)。
图2. AI驱动适配体设计的闭环流程与场景化工具选择
文章最后指出,尽管AI显著加速了候选序列的虚拟预筛选,但当前仍面临数据标准化缺失、模型可解释性不足、对化学修饰核苷酸编码能力有限等挑战。未来应进一步结合主动学习、多模态数据融合和前瞻性实验验证,构建闭环、可解释的AI框架,协调计算预测与实验验证之间的反馈,从而提高适配体设计的成功率与临床转化效率。
该研究以“超越SELEX:AI驱动的适配体——从序列到结构再到功能”(Beyond SELEX: AI-driven aptamers from sequence to structure to function)为题,于10月20日在线发表于《生物技术进步》(Biotechnology Advances)。
北京清华长庚医院药学部崔博铭博士为论文第一作者,王兰、杨歌为论文共同通讯作者。
研究工作得到了中国医学科学院医学与健康科技创新工程(CIFMS)和北京研究型病房卓越计划(BRWEP)的资助。
学术论文推荐
- 阅读